


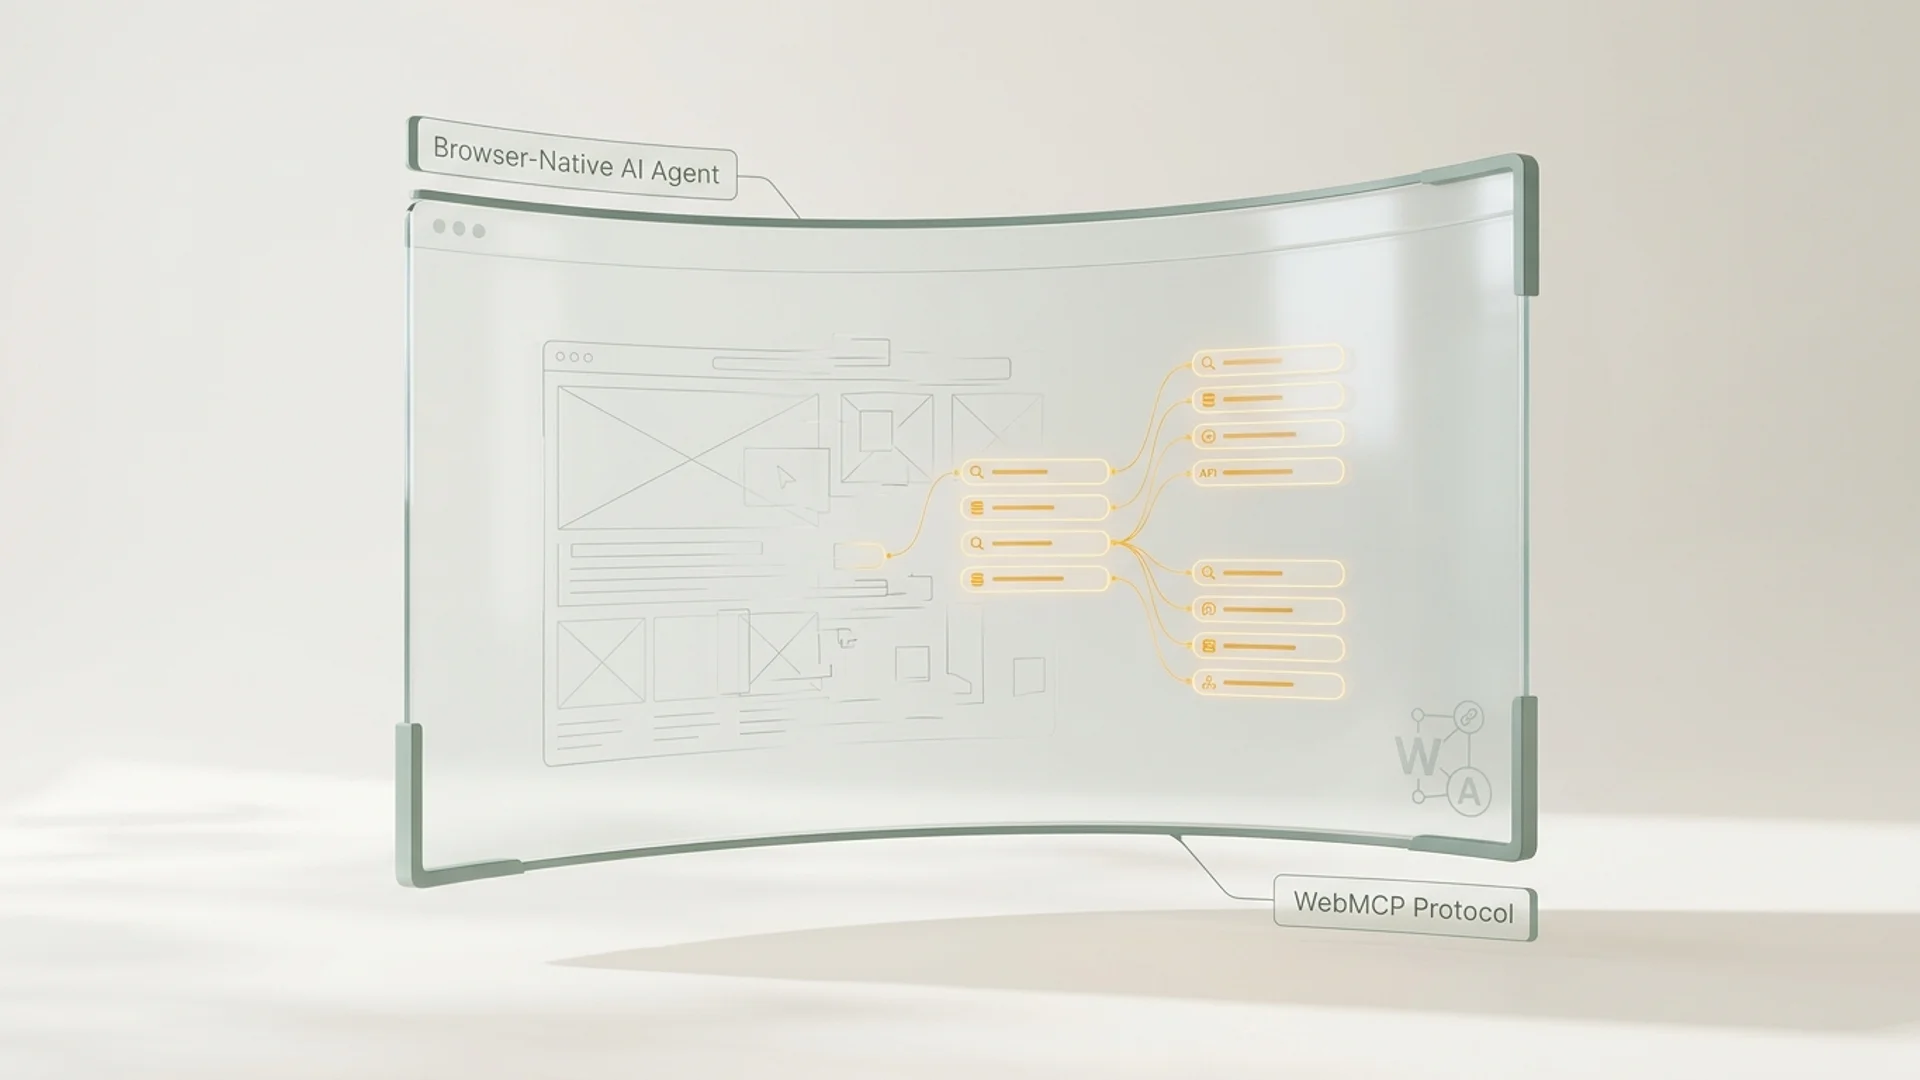
De nieuwste generatie AI-assistenten, waaronder Google Project Mariner, Claude Computer Use en OpenAI Operator, navigeert rechtstreeks binnen de browser. Toch stuiten deze geavanceerde agents massaal op een onzichtbare muur: de complexiteit van het moderne Document Object Model (DOM). Waarom visuele browser-scraping faalt in commerciële toepassingen en hoe WebMCP een revolutie ontketent.
In het kort
Het DOM-Scraping Probleem: Browser-agents die proberen te navigeren via visuele screenshots en HTML-elementen crashen regelmatig door dynamische React/Vue rendering, cookie-banners en trage UI-animaties.
Enorme Token- & Latency-Kosten: Het ‘lezen’ van een complete webpagina via screenshots of ruwe DOM-bomen kost 50.000 tot 100.000 tokens per interactiestap.
De Oplossing (WebMCP): Websites voorzien van embedded machine-readable WebMCP manifesten stellen browser-agents in staat om direct native tools aan te roepen, zonder één visueel element te hoeven ‘klikken’.
De Beperkingen van Visuele Browser-Navigatie
Toen “Computer Use” en browser-native agents begin 2026 debuteerden, leek het alsof AI-agents het web precies zoals mensen zouden gebruiken: visueel kijken, muisklikken simuleren en tekst invoeren in formulieren.
In de praktijk van grootschalige commerciële transacties blijkt deze benadering echter uiterst kwetsbaar:
- Visuele Instabiliteit: Een kleine CSS-wijziging, een pop-up overlay of een trage font-laadtijd zorgt ervoor dat de vision-parser de knoppen ‘Toevoegen aan winkelmand’ of ‘Specificaties bekijken’ mist.
- De Cookie-Wall Val: AI-agents hebben geen menselijke intuïtie om verplichte AVG/GDPR cookie-dialogen consistent weg te klikken. Veel agents blijven oneindig ‘hangen’ in overlays.
- Explosieve Tokenkosten: Elke visuele screenshot die naar een multimodaal LLM wordt gestuurd om de volgende actie te bepalen, verbruikt duizenden vision-tokens. Een eenvoudig aankoopproces van 5 stappen kost al snel meer dan €1,50 aan rekenkracht per sessie.
Wat is WebMCP en Hoe Werkt Het?
Het Web Model Context Protocol (WebMCP) verplaatst de interactie van visuele simulatie naar semantische micro-endpoints*.
In plaats van dat de AI-agent moet raden waar de gegevens staan in een oerwoud van
``
Wanneer een compatibele browser-agent (zoals Chrome AI of Claude) de pagina betreedt, detecteert hij het WebMCP-manifest en voert hij direct een Zero-Overhead Data Handshake uit.
De Voordelen van Zero-Overhead Handshakes
| Factor | Traditionele DOM-Scraping | WebMCP Protocol | Verbetering |
|---|---|---|---|
| Verwerkingstijd (Latency) | 4.500 ms – 12.000 ms per stap | 80 ms – 150 ms | > 95% Sneller |
| Tokenverbruik per actie | 60.000 – 90.000 tokens | 1.200 – 3.000 tokens | 98% Besparing |
| Transactie Succesratio | 42% (crashes bij pop-ups/DOM) | 99.8% (gestructureerde schema's) | Maximale Betrouwbaarheid |
| Onderhoudsgevoeligheid | Extreem hoog bij elke frontend release | Nul (volledig ontkoppeld van styling) | Toekomstbestendig |
Klaar voor de Browser-Native Toekomst met LLMentry
Met LLMentry implementeert u WebMCP-endpoints automatisch bovenop uw bestaande CMS of e-commerce platform. Uw menselijke bezoekers genieten van uw rijke visuele webshop, terwijl browser-native AI-agents direct en foutloos orders, offertes en zoekopdrachten voltooien.
FAQ (Veelgestelde Vragen)
Wat is het verschil tussen het Model Context Protocol (MCP) en WebMCP?
MCP draait voornamelijk op server- en desktopniveau tussen AI-applicaties en databases. WebMCP is de officiële webbrowser-extensie van ditzelfde protocol, waardoor AI-agents binnen webbrowsers rechtstreeks data en acties kunnen aanroepen zonder visuele DOM-scraping.
Werkt WebMCP ook als een bezoeker een gewone webbrowser zoals Safari of Chrome gebruikt?
Ja. WebMCP is een onzichtbare microdata-laag die standaard webbrowsers niet vertraagt of beïnvloedt. Alleen wanneer een AI-agent de pagina bezoekt, leest de agent het WebMCP-manifest uit.
Hoeveel rekenkracht en serverbelasting bespaart WebMCP voor mijn webshop?
Omdat WebMCP-requests direct naar gestructureerde JSON-endpoints gaan in plaats van zware HTML-rendering en client-side JavaScript, daalt de serverbelasting tot wel 80% bij frequente AI-crawls.